№012
52주 신고가 모멘텀은 효과가 있을까? George·Hwang(2004) 리뷰
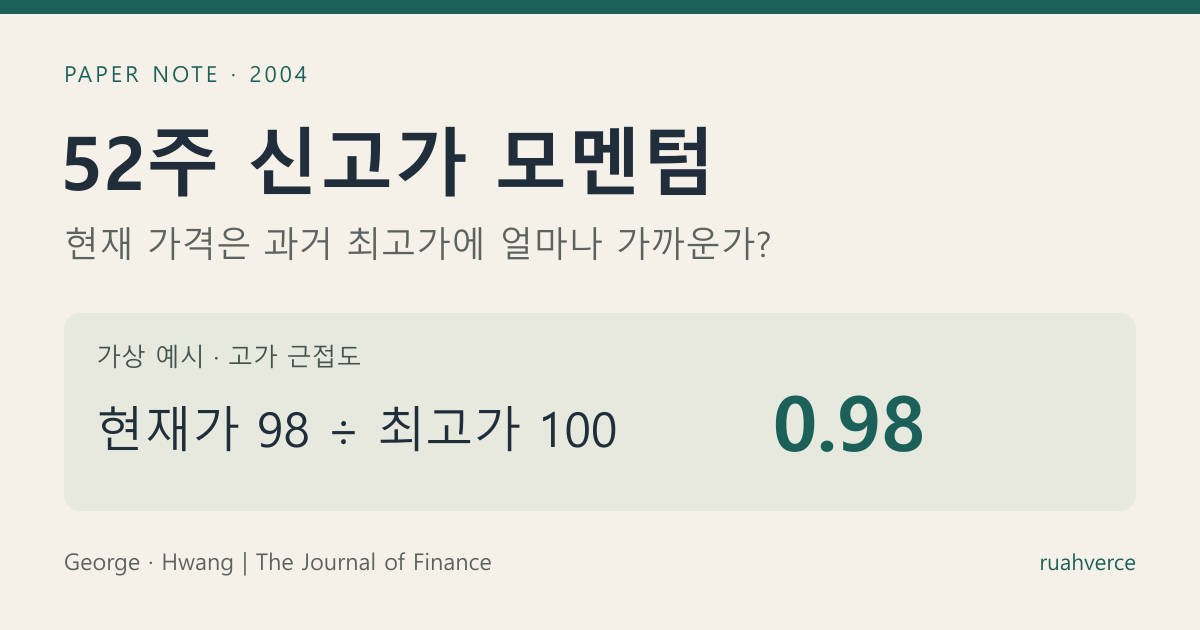
52주 신고가에 가까운 주식은 더 오를까요? George·Hwang(2004)의 고가 근접도 계산법과 모멘텀 비교, 한국 시장 후속 연구를 정리합니다. 거래비용·1월 효과·돌파와의 차이, 실제 백테스트에 적용할 때의 한계도 살펴봅니다.
Tag index
52주 신고가에 가까운 주식은 더 오를까요? George·Hwang(2004)의 고가 근접도 계산법과 모멘텀 비교, 한국 시장 후속 연구를 정리합니다. 거래비용·1월 효과·돌파와의 차이, 실제 백테스트에 적용할 때의 한계도 살펴봅니다.
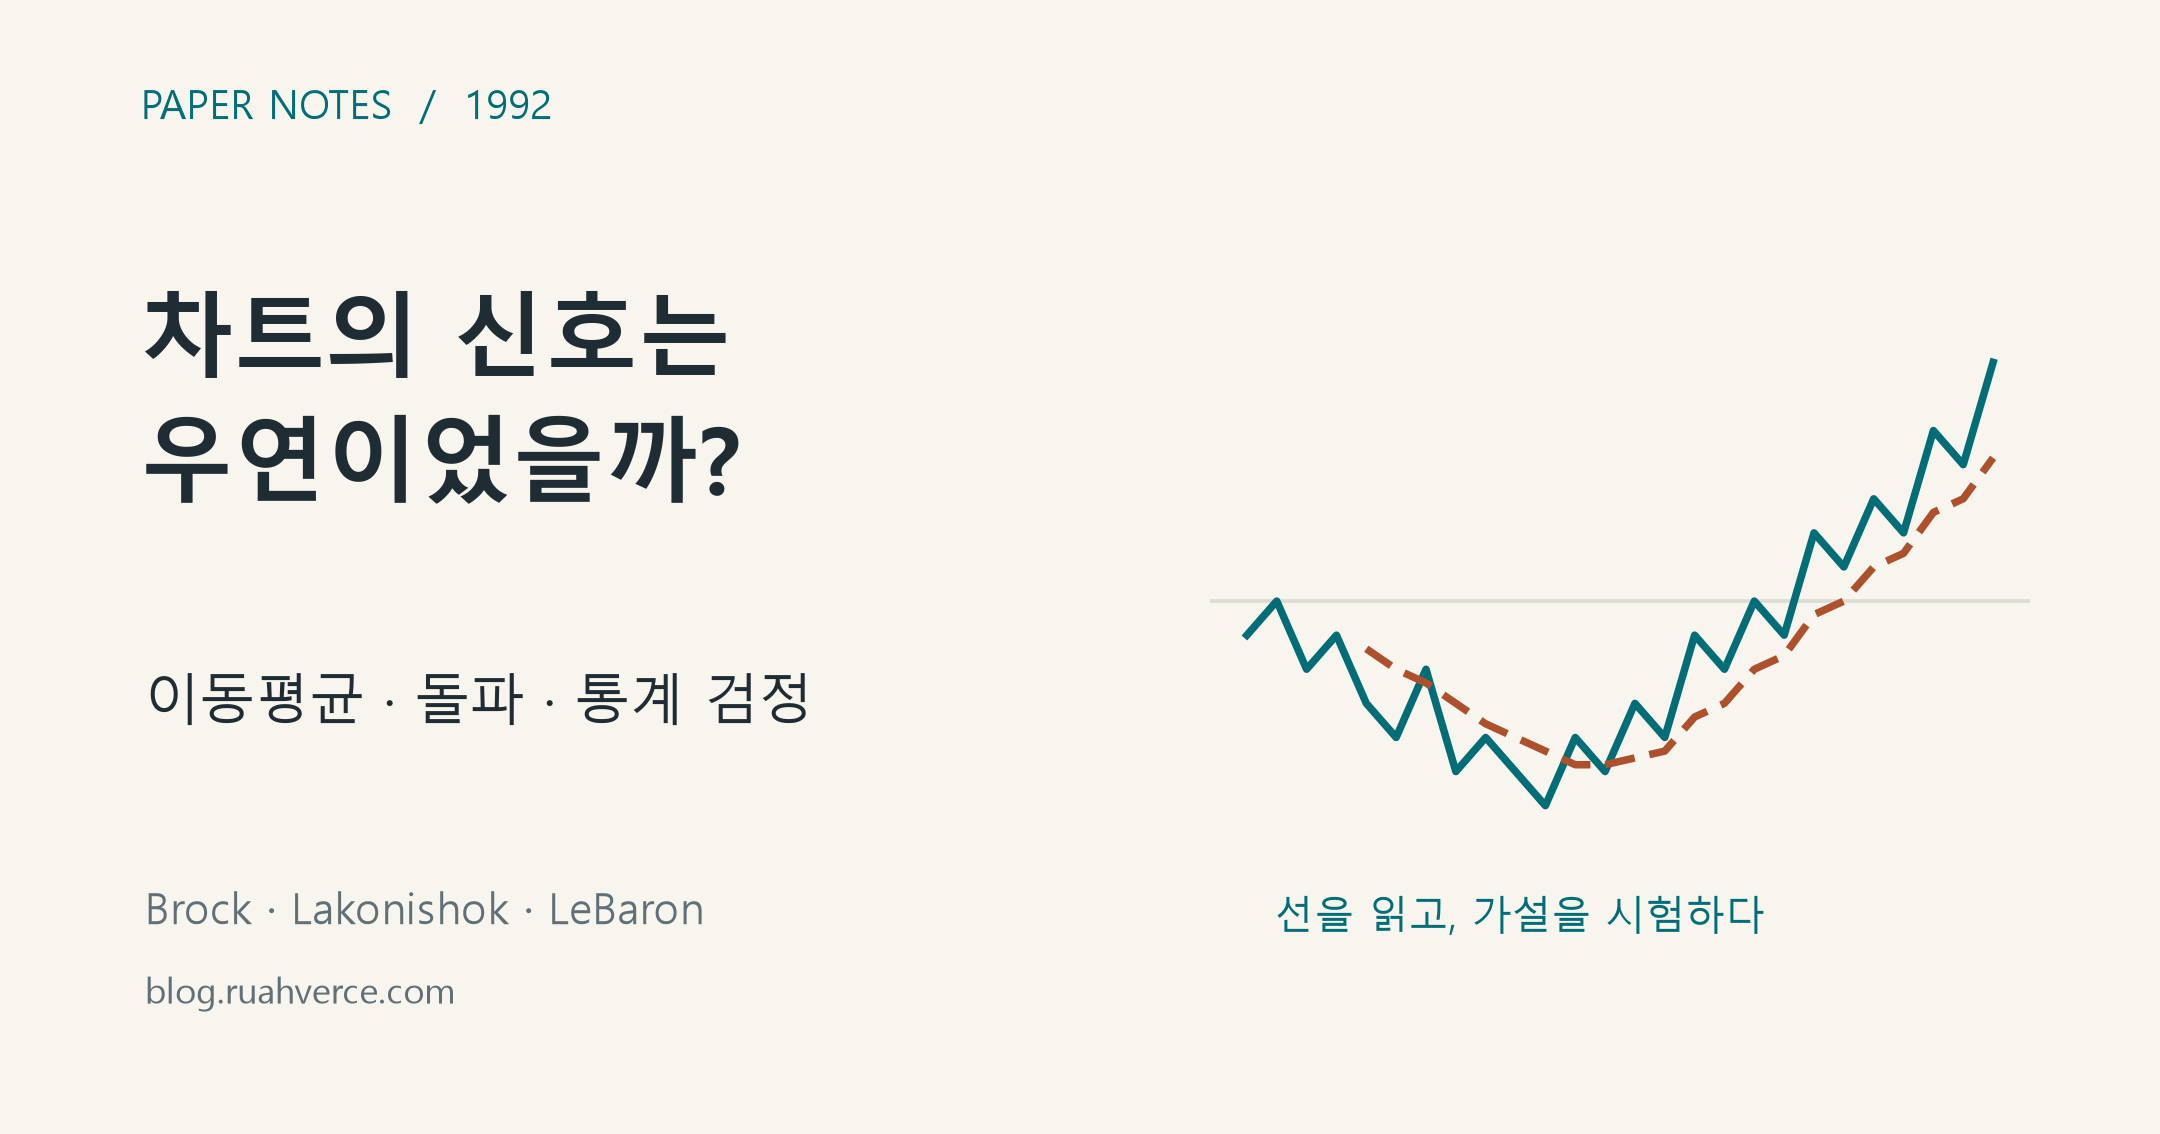
이동평균과 돌파 매매는 효과가 있을까요? Brock 외(1992)의 VMA·FMA·TRB를 쉽게 설명하고, 미국·한국 주식으로 실행한 백테스트 결과와 자산 추이·매매 차트를 함께 정리합니다. 단순 보유와의 차이, 거래비용과 데이터 한계도 살펴봅니다.
LLM이 위키 전체를 읽지 않고 필요한 문서를 찾는 과정을 FTS·임베딩·RRF·중복 제거·재정렬로 설명하고, 증분 인덱싱과 평가를 갖춘 효율적인 LLM Wiki 구축 순서를 실제 구현 사례로 정리합니다.
Frozen corpus·qrel에서 embedding 학습, exact·ANN 평가와 RAG release gate를 설계합니다. 실행 가능한 작은 검색·metric 예제로 후보 누락과 평가 분모를 검산하고, 실제 모델 실험에 필요한 데이터·버전·비용 기록을 구분합니다.
Frozen candidate set에서 reranker 학습·평가·배포의 계약을 설계합니다. 실행 가능한 작은 metric 예제로 candidate ceiling과 nDCG 분모를 검산하고, 실제 모델 학습·부하 시험에 필요한 조건과 부분 코드의 범위를 구분합니다.
MTEB·MMTEB·BEIR·MIRACL·BRIGHT·AIR-Bench·LongEmbed·ConTEB의 평가 범위를 비교하고, 집계 점수·데이터 오염·버전·재현성 함정을 피하는 benchmark card를 만듭니다.
STS·분류·clustering·bitext·retrieval metric을 구분하고 qrel·exact search·ANN recall·paired bootstrap·slice·RAG utility까지 포함한 재현 가능한 embedding 평가법을 설계합니다.
고정 candidate에서 reranker 효과를 분리하고 Recall ceiling, MRR·MAP·nDCG, paired confidence interval을 계산합니다. BEIR·BRIGHT·AIR-Bench의 역할과 latency·비용·최종 RAG 평가까지 설계합니다.
Monolingual·cross-lingual retrieval을 분리하고 언어 균형, parallel pair, tokenizer와 hard negative를 설계해 한국어·영어·혼합 질의에서 embedding 품질을 평가합니다.
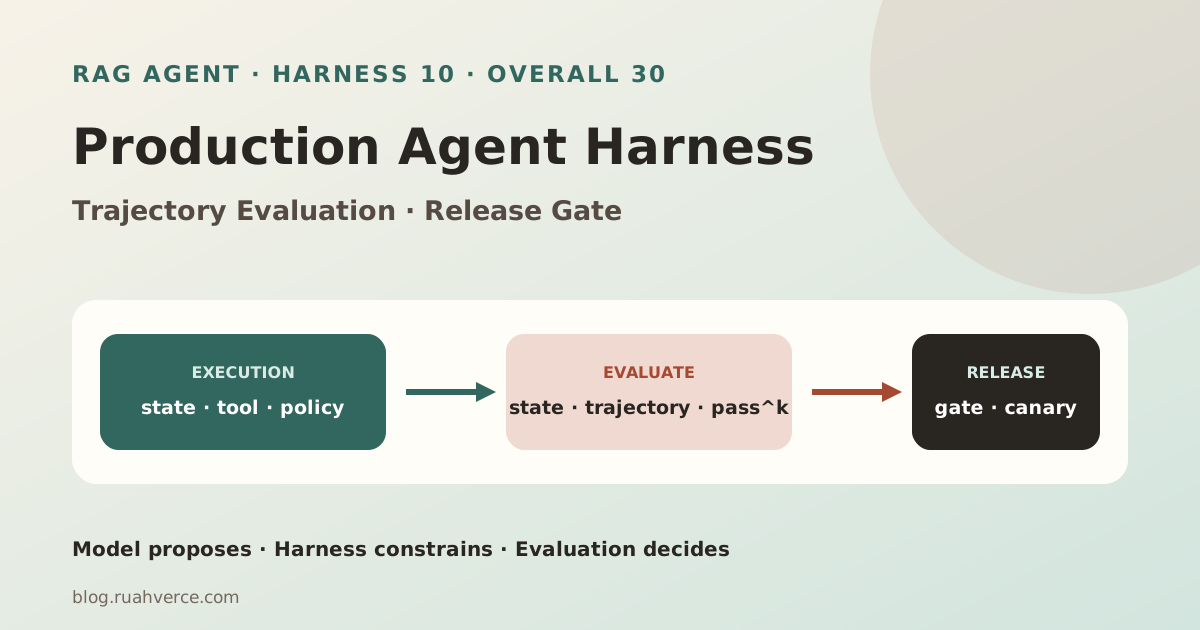
State·tool·router·evidence·memory·durable runtime·trace·security를 production harness로 통합하고 final state와 trajectory의 품질·비용·보안 gate로 안전하게 릴리스합니다.
Chain-of-Thought가 중간 token으로 계산을 확장하는 원리를 익히고 정답성·설득력·충실성을 분리합니다. RAG Agent에서는 숨은 생각 대신 증거·도구 결과·검증 기록으로 추론을 감사하는 방법을 설계합니다.
도메인 RAG 검색이 hard coding 개선 뒤에도 막혔을 때, SPLADE 학습 전에 dense·sparse·fusion·rerank stage trace로 실패 원인을 분리한 기록입니다.