№008 llm-wiki-engineering · 04
LLM Wiki와 RAG의 차이: 대체 관계가 아니라 지식 수명주기다 (4/6)
LLM Wiki와 RAG의 차이를 query-time 검색 기술과 build-time 지식 수명주기로 나눕니다. Vector RAG·GraphRAG·Wiki가 한 시스템에서 결합되는 구조와 선택 기준을 설명합니다.
Tag index
LLM Wiki와 RAG의 차이를 query-time 검색 기술과 build-time 지식 수명주기로 나눕니다. Vector RAG·GraphRAG·Wiki가 한 시스템에서 결합되는 구조와 선택 기준을 설명합니다.
Frozen corpus·qrel에서 embedding 학습, exact·ANN 평가와 RAG release gate를 설계합니다. 실행 가능한 작은 검색·metric 예제로 후보 누락과 평가 분모를 검산하고, 실제 모델 실험에 필요한 데이터·버전·비용 기록을 구분합니다.
Matryoshka 차원 축소, float16·int8·binary·PQ 양자화, HNSW·IVF·DiskANN 검색을 분리 평가하고 품질·메모리·지연·재색인의 Pareto frontier를 설계합니다.
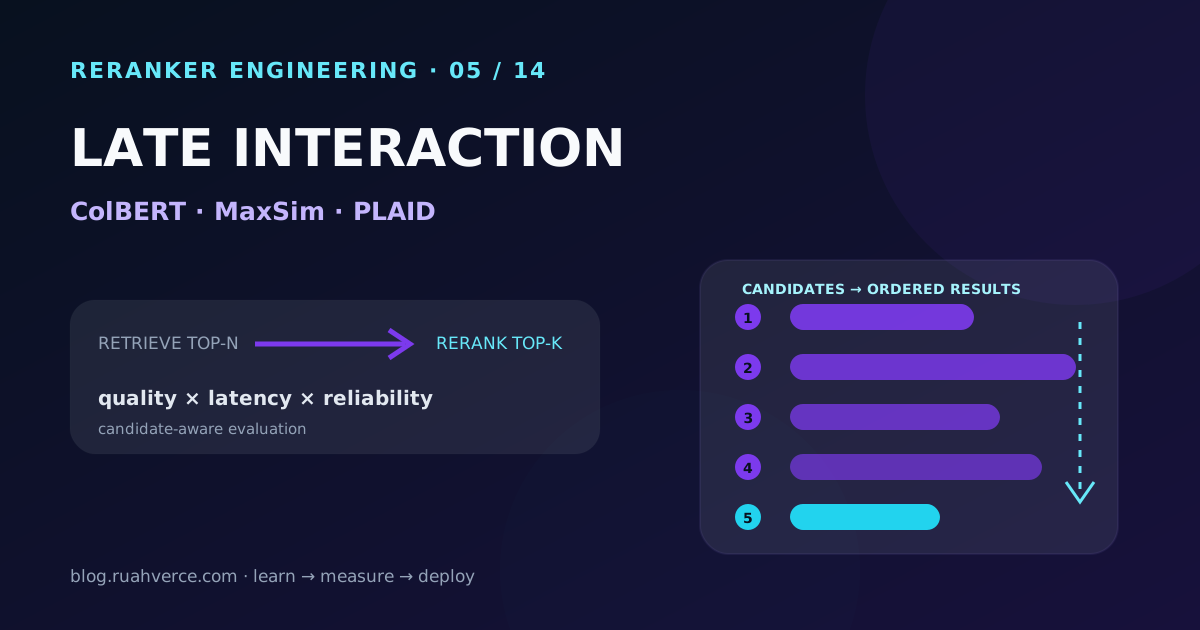
Single-vector bi-encoder와 full Cross-Encoder 사이에서 document token vector를 보존하는 ColBERT의 MaxSim을 계산합니다. ColBERTv2 compression·PLAID 검색과 reranker로 배치하는 기준까지 설명합니다.
RAG embedding model·dimension·chunking·index 설정을 새 generation으로 이전합니다. Snapshot backfill, dual write, shadow read, atomic alias cutover와 rollback을 검증합니다.
Enterprise RAG에서 tenant 경계와 document·chunk ACL을 설계합니다. Filtered ANN, 권한 회수 SLO, cache·reranker·citation까지 이어지는 authorization invariant를 구현합니다.
Exact kNN을 기준으로 HNSW graph, IVF cluster, PQ 압축 원리를 이해하고, ANN Recall@k·p95 latency·memory·build/update 비용을 함께 측정해 corpus와 운영 조건에 맞는 vector index를 선택합니다.
ColBERT Late Interaction은 문서를 토큰별 embedding으로 저장하고 MaxSim으로 질문 단서를 찾습니다. 일반 dense retrieval과 계산 비용 차이를 RAG 관점에서 정리합니다.