№019 embedding-research-engineering · 14
실전: 재현 가능한 Embedding 연구 Pipeline 만들기 (14/14)
Frozen corpus·qrel에서 embedding 학습, exact·ANN 평가와 RAG release gate를 설계합니다. 실행 가능한 작은 검색·metric 예제로 후보 누락과 평가 분모를 검산하고, 실제 모델 실험에 필요한 데이터·버전·비용 기록을 구분합니다.
Tag index
Frozen corpus·qrel에서 embedding 학습, exact·ANN 평가와 RAG release gate를 설계합니다. 실행 가능한 작은 검색·metric 예제로 후보 누락과 평가 분모를 검산하고, 실제 모델 실험에 필요한 데이터·버전·비용 기록을 구분합니다.
LLM backbone과 합성 데이터·증류, 소형·가변 차원, 문맥·추론, 멀티모달·multi-vector, 평가·privacy를 축으로 2024–2026 embedding 연구를 비판적으로 읽습니다.
Matryoshka 차원 축소, float16·int8·binary·PQ 양자화, HNSW·IVF·DiskANN 검색을 분리 평가하고 품질·메모리·지연·재색인의 Pareto frontier를 설계합니다.
MTEB·MMTEB·BEIR·MIRACL·BRIGHT·AIR-Bench·LongEmbed·ConTEB의 평가 범위를 비교하고, 집계 점수·데이터 오염·버전·재현성 함정을 피하는 benchmark card를 만듭니다.
STS·분류·clustering·bitext·retrieval metric을 구분하고 qrel·exact search·ANN recall·paired bootstrap·slice·RAG utility까지 포함한 재현 가능한 embedding 평가법을 설계합니다.
Chunk-then-embed의 문맥 손실부터 long-context single vector, late chunking, CDE·situated embedding, token multi-vector까지 비교하고 긴 문서 retrieval 평가를 설계합니다.
Monolingual·cross-lingual retrieval을 분리하고 언어 균형, parallel pair, tokenizer와 hard negative를 설계해 한국어·영어·혼합 질의에서 embedding 품질을 평가합니다.
문서에서 synthetic query를 만들고 Cross-Encoder·LLM teacher로 relabel·distill하며, LoRA·full tuning·model merging을 비교해 작은 in-domain embedding을 안전하게 학습합니다.
INSTRUCTOR·E5부터 LLM2Vec·NV-Embed·GritLM·Qwen3까지 instruction embedding의 입력 계약, decoder attention 변환, pooling과 multi-task 학습의 장단점을 비교합니다.
DPR의 dual encoder에서 ANCE의 global hard negative, RocketQA의 정제, Contriever·RetroMAE의 retrieval pretraining, E5의 대규모 weak supervision까지 학습 recipe를 추적합니다.
Pair·triplet·graded qrel을 설계하고 random·BM25·ANN·teacher hard negative를 채굴하며, false negative와 leakage를 정제하는 재현 가능한 embedding 데이터 파이프라인을 만듭니다.
Positive·negative로 vector 공간을 만드는 InfoNCE, multiple-negatives ranking loss, temperature와 batch size의 효과를 수식·gradient·구현·ablation 관점에서 설명합니다.
Cosine·dot product·L2의 관계와 vector norm, mean·CLS·last-token pooling을 해부하고 anisotropy·hubness·dimension 문제가 실제 nearest-neighbor 검색을 어떻게 바꾸는지 진단합니다.
Token·문장·문서 embedding과 dense·sparse·multi-vector 표현을 구분하고, 학습·평가·검색·서빙으로 이어지는 14편 연구 로드맵과 첫 baseline을 세웁니다.
문서 수집과 chunking부터 embedding·cosine retrieval·context 조립·근거 기반 생성·Recall@k 평가까지 최소 RAG를 Python으로 연결하고, 실패를 검색과 생성 단계로 분리해 추적합니다.
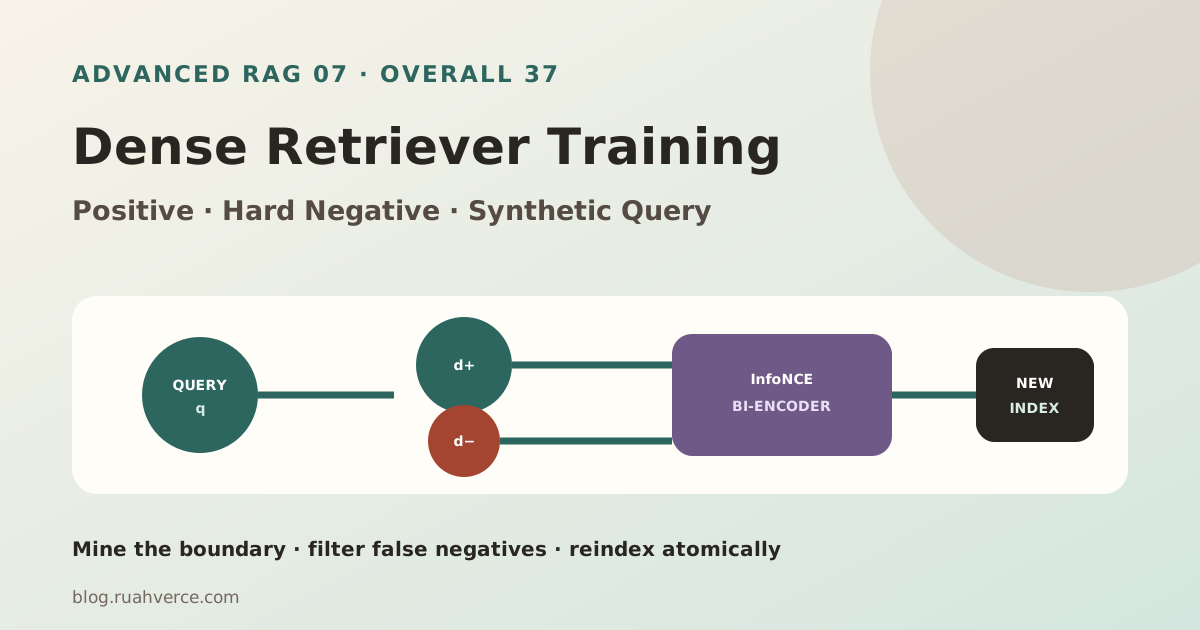
Domain RAG의 dense retriever를 positive·in-batch·hard negative로 학습하고, ANCE mining과 GPL·InPars·Promptagator식 synthetic query를 안전하게 만드는 방법을 설명합니다.
RAG embedding model·dimension·chunking·index 설정을 새 generation으로 이전합니다. Snapshot backfill, dual write, shadow read, atomic alias cutover와 rollback을 검증합니다.
스칼라·벡터·행렬의 차이부터 one-hot과 dense embedding, dot product·cosine similarity·정규화까지 작은 숫자로 계산하고, query와 문서가 검색되는 원리를 RAG 코드로 연결합니다.
고정 길이·overlap·문서 구조·semantic·late chunking의 원리와 비용을 비교하고, tokenizer 기반 구현·parent-child 연결·평가 grid를 통해 자신의 문서와 질문에 맞는 chunk 경계와 크기를 선택하는 방법을 배웁니다.